



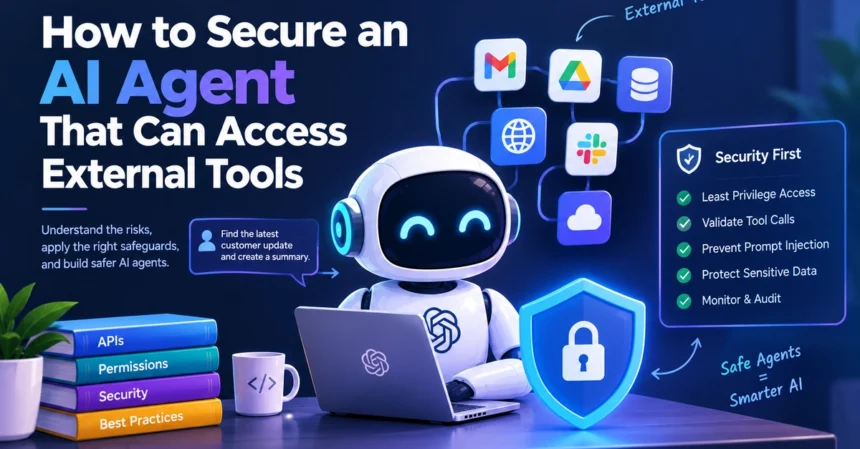
Agjentët AI që lexojnë email, kërkojnë në internet, konsultojnë baza të dhënash dhe përdorin API mund të kursejnë kohë, por krijojnë edhe rreziqe sigurie. Ndryshe nga një chatbot që mund të japë përgjigje të gabuar, një agjent me mjete mund të kryejë veprime të gabuara: të nxjerrë të dhëna, t’i dërgojë mesazh personit të gabuar ose të fshijë skedarë. Shembujt në artikull janë hipotetikë, jo incidente reale.
Parimi kryesor është ndarja e aftësisë teknike nga autorizimi. Modeli mund të zgjedhë një mjet dhe të propozojë parametrat, por aplikacioni duhet të kontrollojë lejet dhe të verifikojë të dhënat hyrëse përpara ekzekutimit. Këto kontrolle duhet të funksionojnë pavarësisht vendimit të modelit; një udhëzim në prompt nuk mjafton si mbrojtje.
Një rrezik kryesor është prompt injection: udhëzime keqdashëse brenda një emaili ose faqeje interneti mund ta shtyjnë agjentin të devijojë nga kërkesa e përdoruesit, për shembull duke përcjellë email te një adresë e jashtme. Përmbajtja e marrë nga burime të jashtme duhet trajtuar si e pabesueshme, ndërsa kufizimet duhet të zbatohen në kod.
Rrezik tjetër janë lejet e tepërta. Një agjent mbështetjeje që duhet vetëm të kontrollojë porositë nuk ka nevojë për qasje leximi dhe shkrimi në çdo tabelë. Dhënia vetëm e lejeve të domosdoshme kufizon dëmet nga gabimet ose manipulimi.
Burimi: DEV Community (Web Dev Feed) — lexoni artikullin e plotë në anglisht.



