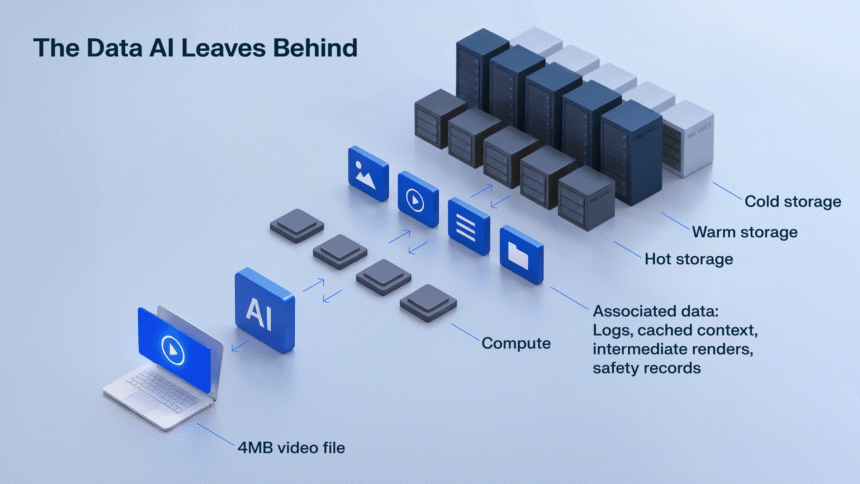
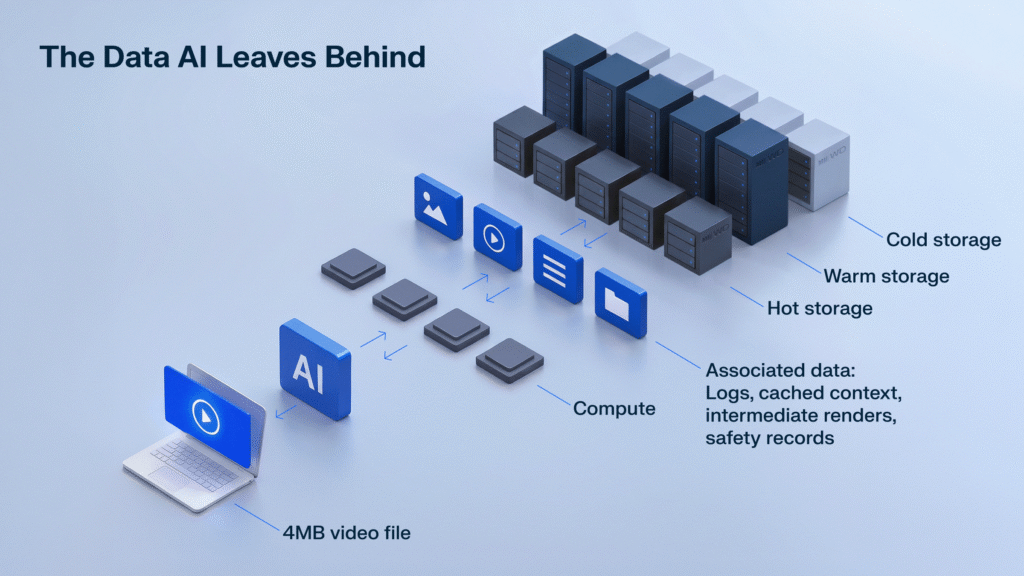
Kostot e infrastrukturës së AI-së nuk kufizohen te GPU-të dhe energjia. Çdo përgjigje e modelit gjeneron të dhëna që mund të duhen ruajtur, nga regjistrat dhe konteksti në cache te kopjet rezervë. Ndryshe nga trajnimi, që ka fillim dhe fund, inferenca zhvillohet vazhdimisht, duke shtuar vëllimin e të dhënave dhe shpenzimet e ruajtjes, shpesh të anashkaluara në planifikim.
Sipas matjeve të brendshme të WD-së, një video 8-sekondëshe, e dorëzuar si skedar 720p prej 3.97MB, la pas mbi 500MB të dhëna mbështetëse, përfshirë regjistra, materiale të ndërmjetme dhe të dhëna sigurie. Kjo është rreth 130 herë madhësia e skedarit që mori përdoruesi.
McKinsey parashikon që kërkesa për inferencë të rritet mesatarisht 35% në vit deri më 2030, kundrejt 22% për trajnimin, dhe të përbëjë mbi 40% të kërkesës totale të qendrave të të dhënave. Një studim global i IDC-së, i sponsorizuar nga WD dhe me 763 vendimmarrës të IT-së dhe biznesit, gjeti se afro 95% raportuan shtim të të dhënave nga AI gjeneruese gjatë 12 muajve të fundit; rreth 61% raportuan rritje prej të paktën 25%.
Të dhënat e ruajtura vazhdojnë të grumbullohen edhe kur kërkesa për përpunim bie. Planifikimi duhet të marrë parasysh edhe furnizimin e GPU-ve me të dhëna: pritja pa punë e këtyre pajisjeve mund të bëhet shpejt e kushtueshme.
Burimi: MIT Technology Review — lexoni artikullin e plotë në anglisht.