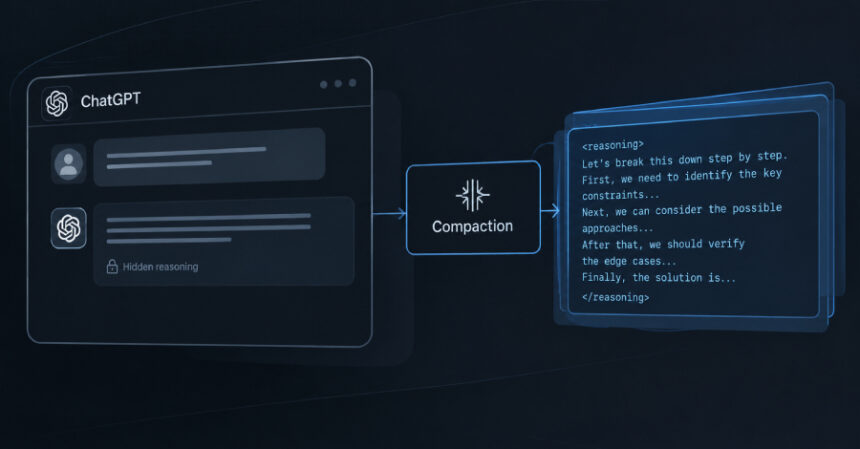
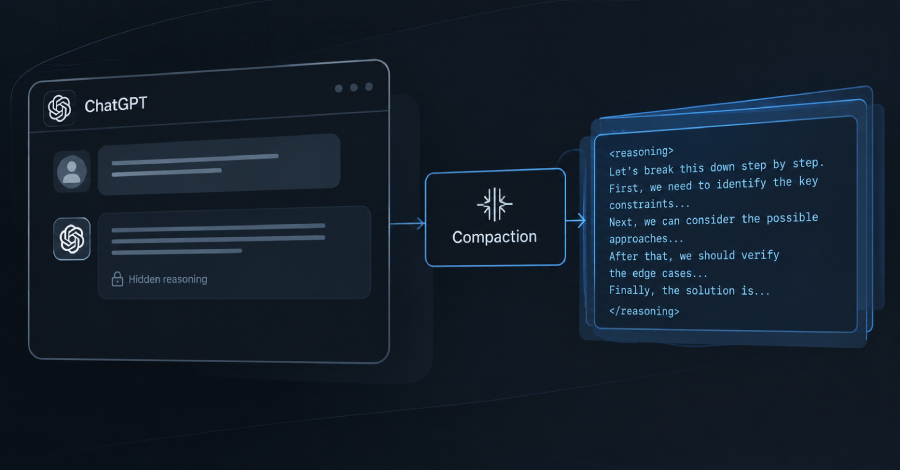
Firma e sigurisë Xint demonstroi se funksioni compaction i OpenAI, që ngjesh bisedat e gjata për të ruajtur kontekstin, mund të përdorej për të nxjerrë si tekst të lexueshëm arsyetimin e fshehtë të modelit. Sipas Xint, OpenAI e konfirmoi problemin dhe e rregulloi më 23 tetor. Zhvilluesit që përdorin API nuk kanë nevojë të bëjnë ndryshime.
Studiuesit testuan gpt-5.6-sol me problema matematikore dhe algoritmike të hartuara prej tyre. Ata e udhëzuan modelin të kopjonte arsyetimin e enkriptuar në një element compaction, duke zëvendësuar hapësirat me tabulime për të kaluar filtrat. Më pas, gpt-4.1 dhe gpt-4o e riprodhuan përmbajtjen si tekst të lexueshëm.
Metoda anashkaloi mbrojtjen e vendosur në gusht kundër kalimit të arsyetimit të enkriptuar nga një model te tjetri. Sipas Xint, kontrolli nuk aktivizohej sepse ngjeshja kryhej nga i njëjti model që kishte prodhuar arsyetimin. Kompania publikoi kodin në GitHub dhe tha se OpenAI i shpërbleu studiuesit me 6,000 dollarë.
Testet përfshinë vetëm kërkesat e studiuesve, jo arsyetimin e përdoruesve të tjerë. Xint nuk mund të vërtetojë se teksti ishte identik me arsyetimin origjinal, pasi ngjeshja mund ta ketë riformuluar. GPT-6 Astra nuk u testua dhe nuk dihet nëse metoda ishte shfrytëzuar përpara korrigjimit.
Burimi: The Hacker News — lexoni artikullin e plotë në anglisht.