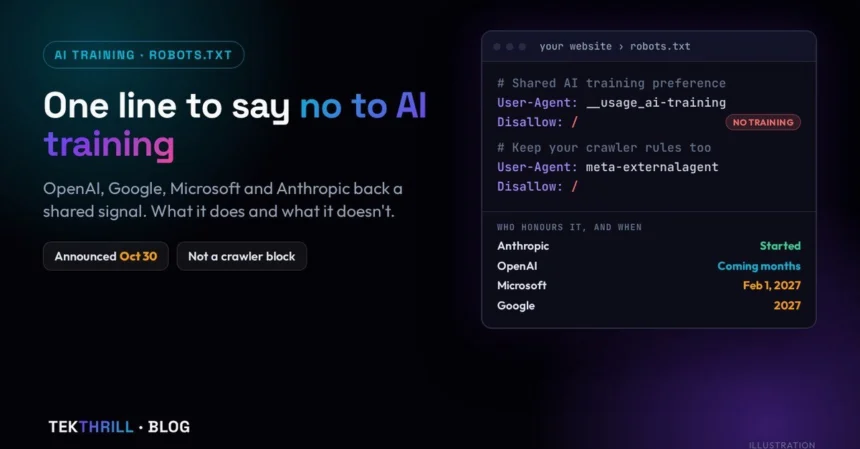
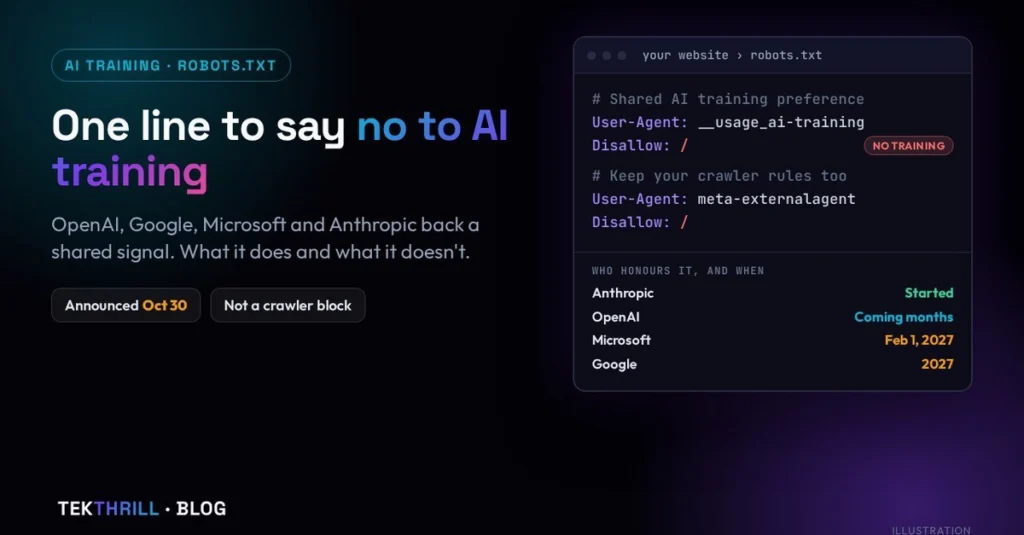
Më 30 tetor 2026, OpenAI, Google dhe Microsoft njoftuan mbështetjen për një sinjal të përbashkët në robots.txt, që u lejon faqeve të shprehin nëse përmbajtja e tyre mund të përdoret për trajnimin e AI. Anthropic tha se ka nisur zbatimin, por mbulimi i të gjitha shërbimeve do të kërkojë kohë.
Propozimi është paraqitur si draft në Internet Engineering Task Force (IETF) nga Kevin Kelley, drejtues teknik për standardet në Anthropic. Synimi është që botuesit dhe bizneset të shprehin preferencën me një rregull të përbashkët, në vend që të renditin veçmas crawler-at e çdo kompanie dhe të përditësojnë listën.
Sinjali përdor token-in __usage_ai-training në fushën User-Agent. Shembulli i draftit kombinon “User-Agent: __usage_ai-training”, “Disallow: /” dhe “Allow: /press-kit/”: refuzon trajnimin me përmbajtjen e gjithë faqes, përveç dosjes /press-kit/.
Ky mekanizëm shpreh preferencën për përdorimin e përmbajtjes, por nuk bllokon hyrjen e crawler-ave; për këtë duhen rregulla me emrat e tyre. Rregulli i përgjithshëm “User-Agent: *” nuk llogaritet si preferencë për trajnim, ndërsa rregullat specifike për kompanitë kanë përparësi. Burimi: https://tekthrill.com/blog/shared-ai-training-opt-out-robots-txt-india/
Burimi: DEV Community (Web Dev Feed) — lexoni artikullin e plotë në anglisht.