Cerebras shpjegon si shpërndan modele AI me triliona parametra në disa çipa WSE-3T, duke synuar shpejtësi prej 1000–2000+ tokenësh në sekondë. Çdo çip ka 44 GB memorie të integruar, ndërsa vetëm peshat e modeleve të tilla kërkojnë terabajte hapësirë.
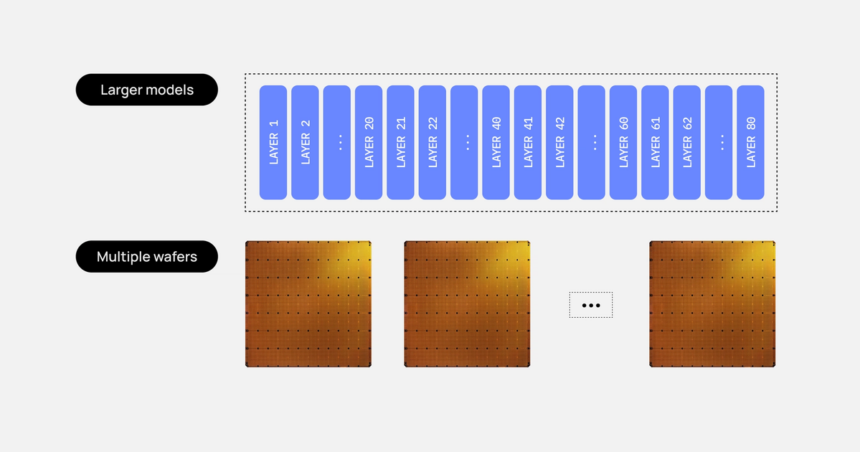
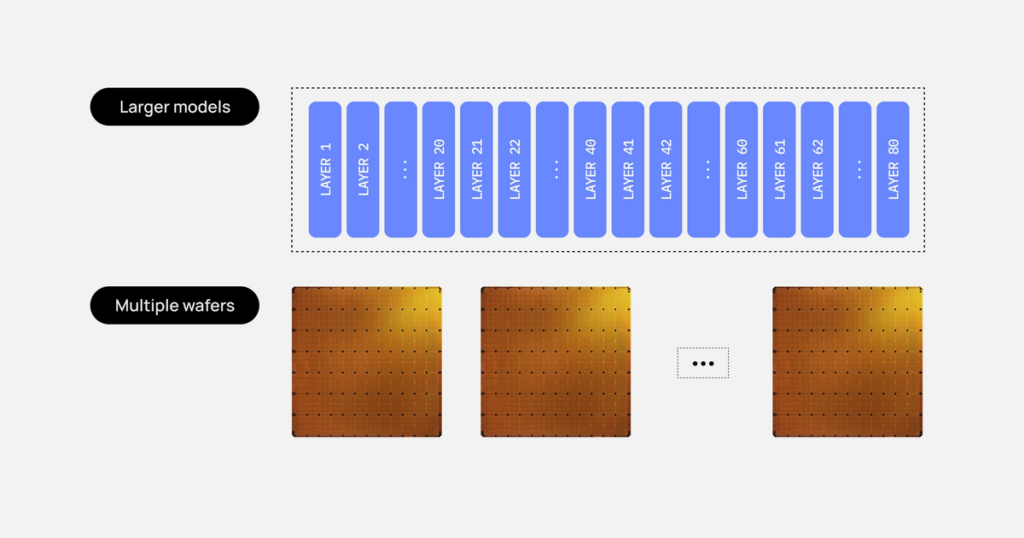
Si shembull përdoret Kimi K3, model me burim të hapur me rreth 3 trilionë parametra, 69 shtresa me vëmendje lineare dhe 24 shtresa të dendura. Sipas përllogaritjes së paraqitur, me parametrat të ruajtur në 4 bitë dhe rreth 16 GB për shtresë, nevojiten 59 çipa: 35 për shtresat lineare dhe 24 për ato të dendura.
Shtresat ekzekutohen në një zinxhir fazash përpunimi. Peshat zakonisht mbeten në memorien SRAM të çipit, ndërsa mes çipave kalojnë vetëm aktivizimet përmes RDMA mbi Ethernet, me rreth 2 mikrosekonda për kalim. Kjo shmang nevojën për zhvendosjen e vazhdueshme të peshave ose ndarjen e shumicës së shtresave mes çipave.
Për të shfrytëzuar sistemin, fazat përpunojnë kërkesa të ndryshme njëkohësisht, edhe në grupe të vogla. Grupet më të vogla ulin kohën për kërkesë; më të mëdhatë rrisin kapacitetin e përgjithshëm të përpunimit. Numri maksimal i kërkesave të njëkohshme kufizohet nga memoria e mbetur për KV cache në çipat që mbajnë shtresat e dendura.
Burimi: Hacker News — lexoni artikullin e plotë në anglisht.