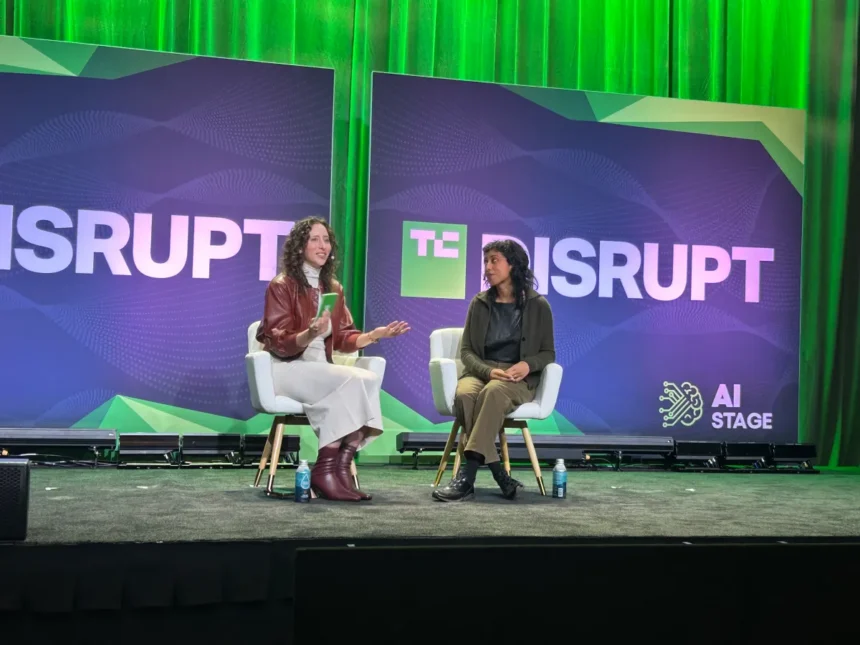
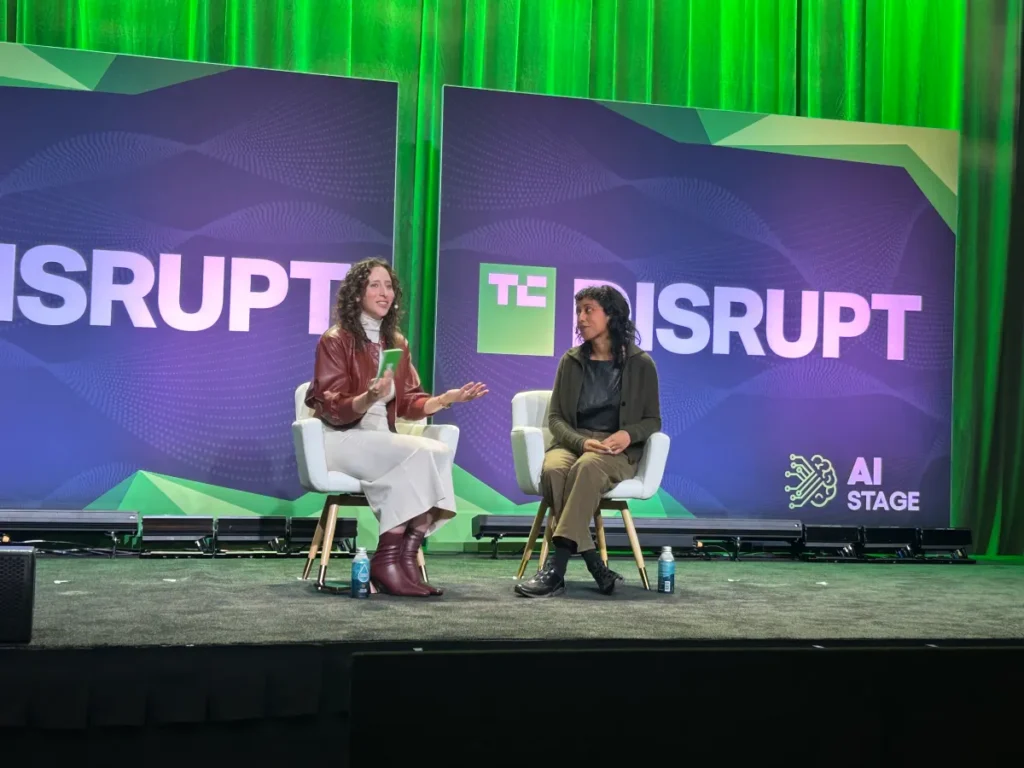
Testet krahasuese të modeleve të inteligjencës artificiale kanë nevojë për standardizim më të madh, tha Irene Solaiman, drejtuese e politikave të Hugging Face, në TechCrunch Disrupt. Sipas saj, metodat janë ende në zhvillim dhe rezultatet mbeten të vështira për t’u krahasuar.
Besueshmëria lidhet me mundësinë për të riprodhuar rezultatet dhe me qasjen e nevojshme te modeli, ku peshat e hapura kanë rol të rëndësishëm. Solaiman paralajmëroi se testet mund të humbasin shpejt efektivitetin dhe se mungon një ekosistem mjaftueshëm i zhvilluar vlerësuesish.
Pas incidenteve të sigurisë, laboratorët kanë mbështetur vendosjen e vlerësuesve të jashtëm brenda organizatave si alternativë ndaj rregullimit aktiv qeveritar. Por paanshmëria dhe aftësitë e tyre mbeten në diskutim. Zgjedhja e Accenture si vlerësuesi i parë i Anthropic nxiti kritika për kualifikimet e kompanisë konsulente.
Vlerësimi po shtrihet nga modeli te i gjithë sistemi, përfshirë agjentin dhe mjetet përmes të cilave përdoret modeli, të njohura si «harness». Një model më i dobët me mjete më të mira mund të tejkalojë një model të avancuar. Testimi i agjentëve është i vështirë dhe i kushtueshëm, ndërsa testet për këto mjete janë më të pakta, çka e shton nevojën për standarde të përbashkëta.
Burimi: TechCrunch – AI — lexoni artikullin e plotë në anglisht.